-
作者帖子
-
2026年9月9日 上午12:17 #107
 teaikeji管理员
同一模型、同一配方、同一压测工具、同一批场景,跑满四轮,构成三条横比线。每次只变一个变量,差异就能归因:
- 横比一:A100 / PPU / 910B3 三种卡(各 2 张,TP2),权重同为 BF16,配方同一份
- 横比二:同一套 910B3、同一份配方,只把权重从 BF16(52GB)换成 w8a8(30GB)
- 横比三:同一套 PPU、同一份权重,只改一个参数 cudagraph_mode——这条线来自横评过程中的一次异常排查:PPU 首轮 MTP 接受率断崖式下降,定位后确认是引擎缺陷,换配方重跑
下面先交代装置与测试方法,再按三条线逐条解读。
一、实验装置与校准
跨硬件对比最大的风险是两侧测量口径不一致:压测工具口径、投机解码是否真的生效、前缀缓存状态,任何一项差异都能造成几十个百分点的偏差,而且不会报错。所以开跑前先做对账:拿 A100 一轮与同型号卡上一组已公开的 Qwen3.8-27B 实测数据(参考链接1)对比,判据取单流延迟用例(五个用例中唯一规格明确、可严格对账的):
- TTFT 均值:本轮 94.57 ms,公开数据 88.56 ms,偏差 +6.8%
- 单流输出吞吐:126.5 tok/s vs 129.26 tok/s,偏差 -2.1%
- 输入吞吐:179.7 vs 181.72 tok/s,偏差 -1.1%
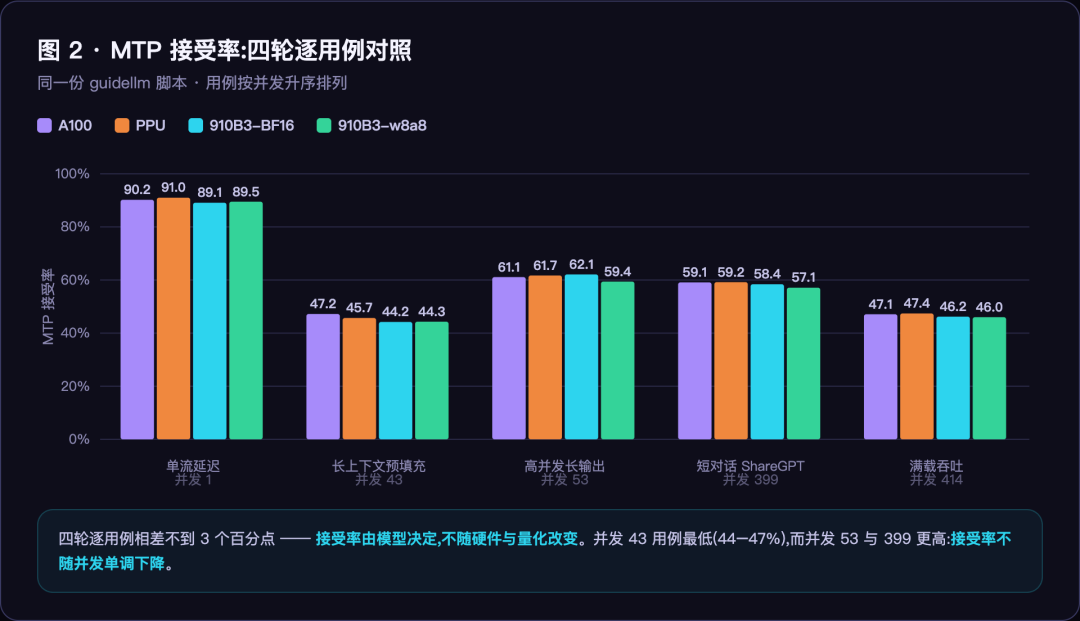
三项偏差都在 7% 以内。第二个校准点是 MTP 接受率:四轮逐用例相差不到 3 个百分点。接受率由模型决定,不随硬件和量化改变,四轮一致即可确认投机解码在四轮里都生效了。
二、测试方法
- 压测工具:guidellm 0.7.3(参考链接2),四轮同一份脚本、同一份配置,走 OpenAI 兼容接口打服务端
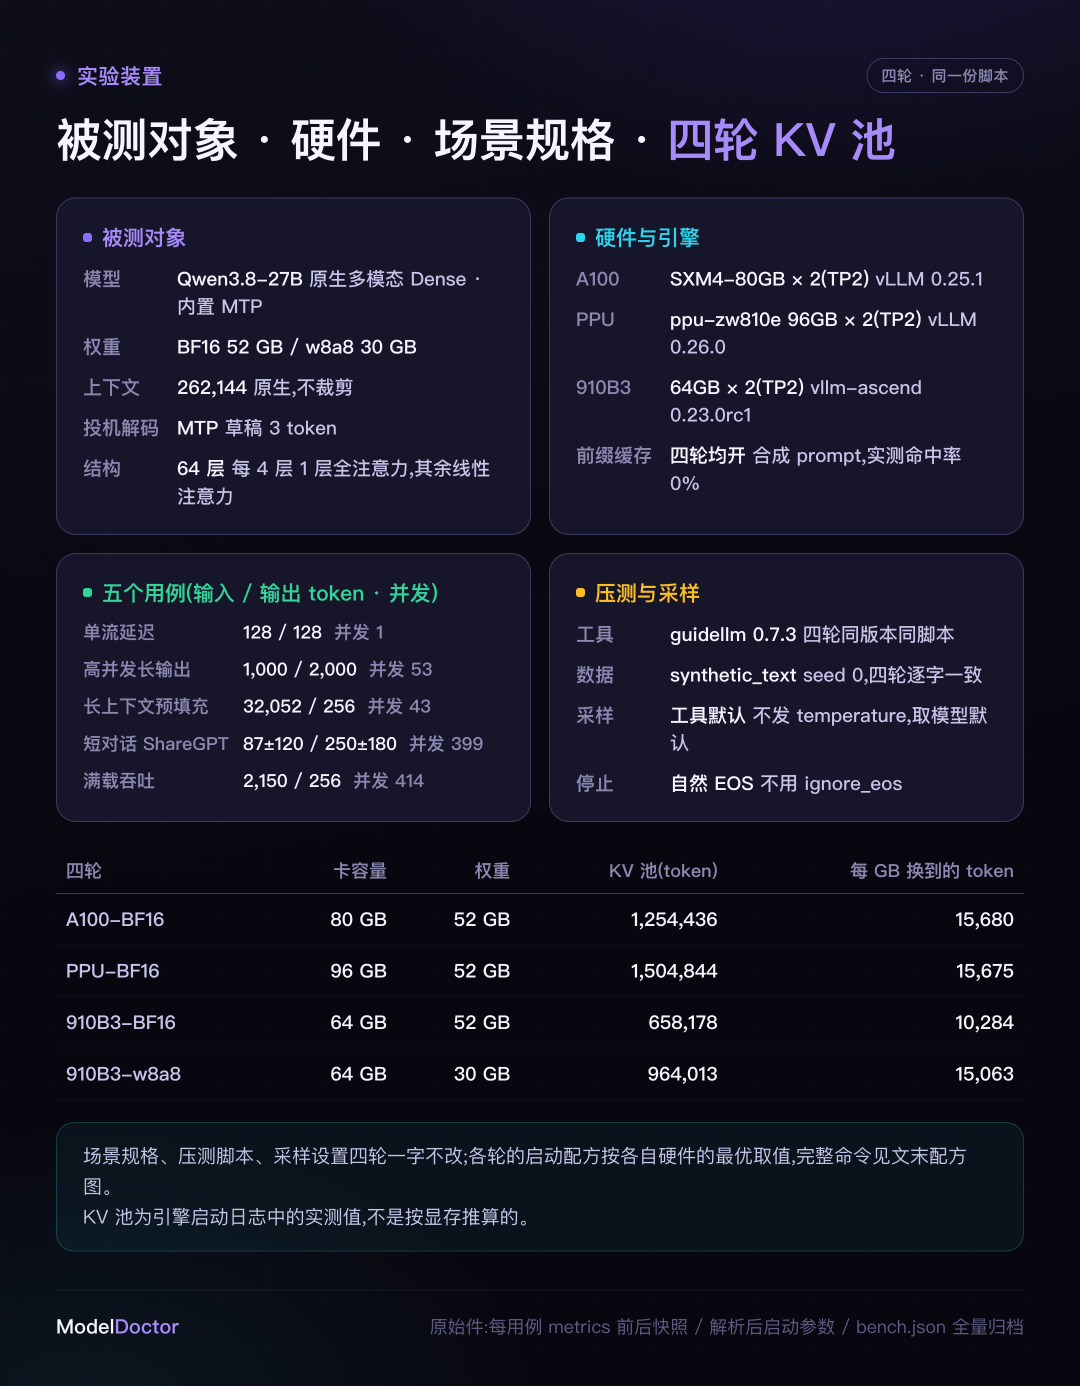
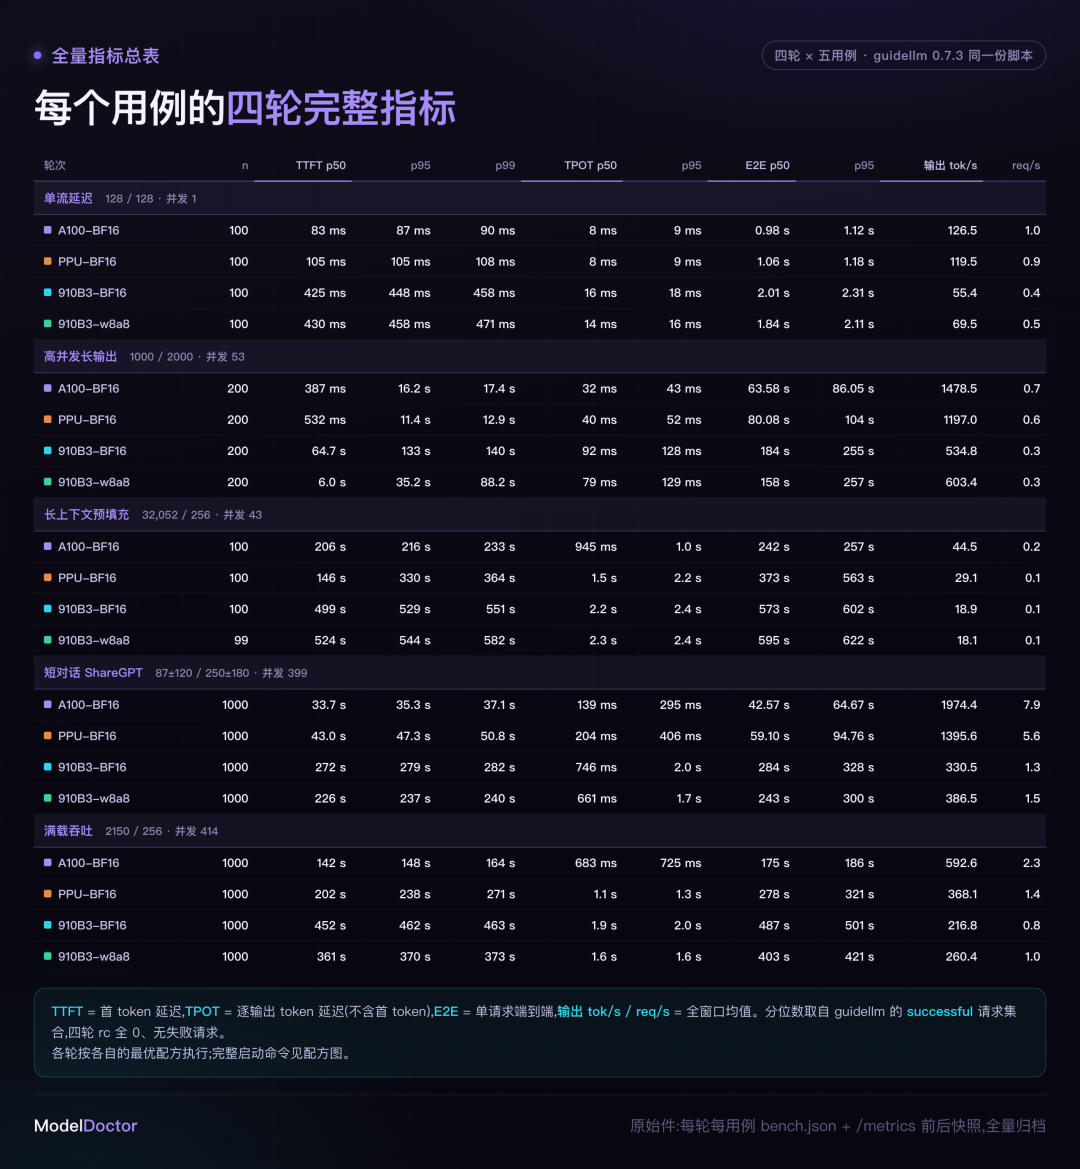
- 数据集:五个用例均由 guidellm 的 synthetic_text 生成,token 规格与并发见图 1,四轮逐字一致;短对话用例是按公开数据反推的合成分布(87±120 入 / 250±180 出),不是真实 ShareGPT
- 执行规程:起服务等 /health 就绪;每个用例开跑前打 /metrics 快照;跑 guidellm(固定 –seed 0,max_requests 与 max_duration 双约束);跑完再打快照,取增量得到前缀命中率、抢占次数、MTP 接受率;落盘 bench.json + 前后快照 + 完整启动参数
- 指标口径:TTFT = 首 token 延迟;TPOT = 逐输出 token 延迟(不含首 token);E2E = 单请求端到端;分位数取 successful 请求集合
- MTP 接受率不是压测工具的输出项,是从引擎计数器 spec_decode_num_accepted_tokens / num_draft_tokens 在测量点前后取差值算的,四轮各组数均通过计数器自洽校验
四轮全部用例 rc 为 0,无失败请求。完整数据见图 2~图 8。
三、横比一:三种卡(BF16 同配方)
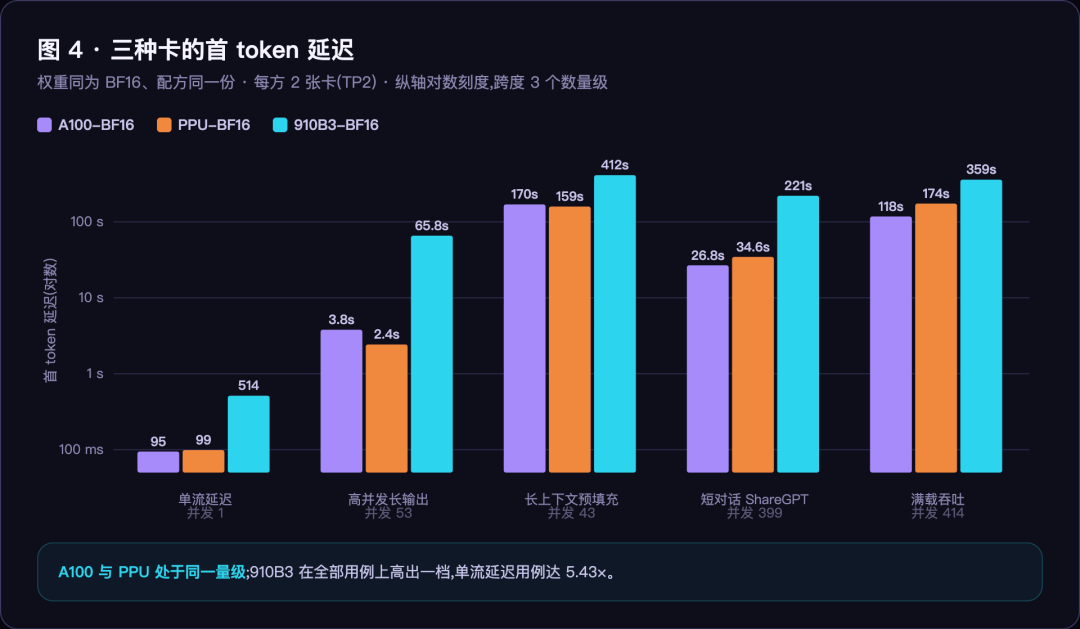
A100 与 PPU 处于同一量级:
- 单流两项指标均为 1.05 倍(TTFT 99.0 vs 94.6 ms,逐 token 7.66 vs 7.3 ms)
- 高并发长输出与长上下文预填充用例 PPU 更优(0.64 倍 / 0.94 倍)
- 短对话与满载吞吐用例 A100 更优(1.29 倍 / 1.48 倍)
- 输出吞吐 A100 在全部用例领先
两者在不同负载形态下各有优势,归不成单一倍数。PPU 与 A100 软件栈同源(引擎自报值:device_config=cuda、nccl 2.27.3、all-reduce 走 PYNCCL、vLLM 官方主线 0.26.0,A100 为 0.25.1)。
910B3 的首 token 显著偏高:单流延迟用例 514.0 ms,是 A100 的 5.43 倍;而同用例逐 token 只差 2.04 倍。两个指标倍数不在一个量级,成因见第六节。
四、横比二:两个权重文件(910B3)
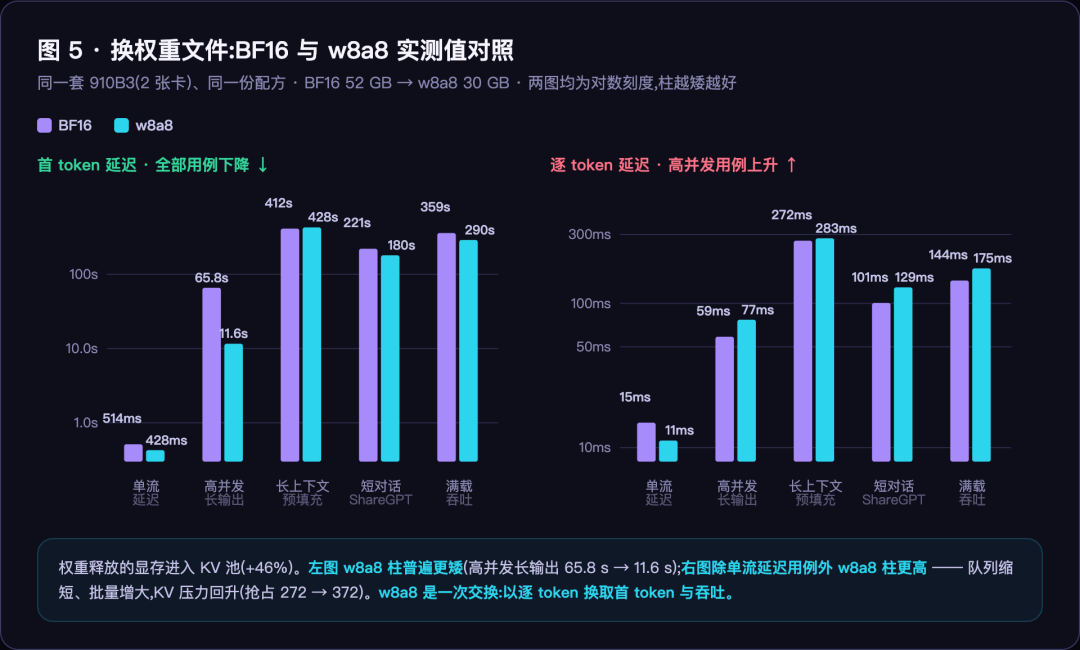
权重从 52GB 降到 30GB,释放的显存进 KV 池(+46%,658,178 → 964,013 token)。结果两个方向:
- 首 token 全部用例下降:高并发长输出 TTFT 从 65.8s 降到 11.6s(-82%),满载吞吐用例抢占从 103 次降到 0
- 但逐 token 在高并发用例上升 21~31%
机制:TTFT 下降让单位时间进系统的请求变多,批量增大,KV 压力回升。抢占次数从 272 增到 372 支持这一解释——池容量提高了,但请求增量更大。所以 w8a8 不是无代价的加速,而是一次交换:拿逐 token 延迟换首 token 延迟和吞吐。
五、横比三:一个参数(PPU 的 cudagraph_mode)
PPU 首轮 MTP 接受率断崖:高并发段从 50%+ 掉到 1% 左右。排查过程:
- 只改温度无效:temperature=0 为 73.62%,1.0 为 43.97%,0.1~1.0 之间无单调趋势——温度让接受率降一档,但不会归零
- 换提示词也无效:连贯文本与随机词串逐用例一致
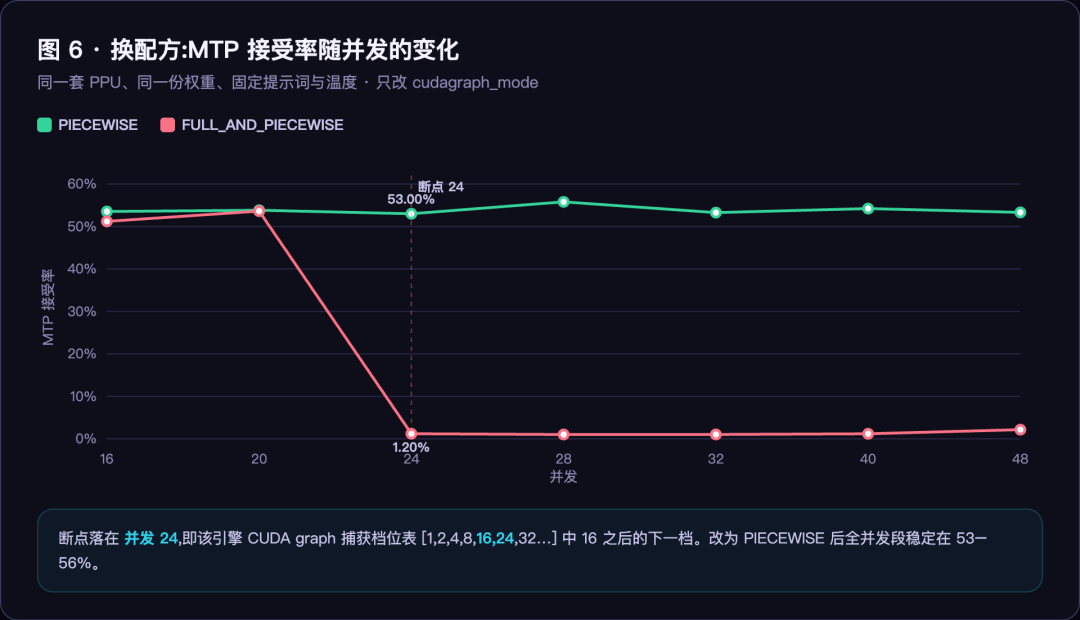
- 决定变量是并发,且是断崖不是渐降:并发 16 / 20 / 24 / 32 / 48,接受率 51.20% / 53.62% / 1.20% / 1.03% / 2.16%——并发 20 到 24 之间掉了两个数量级
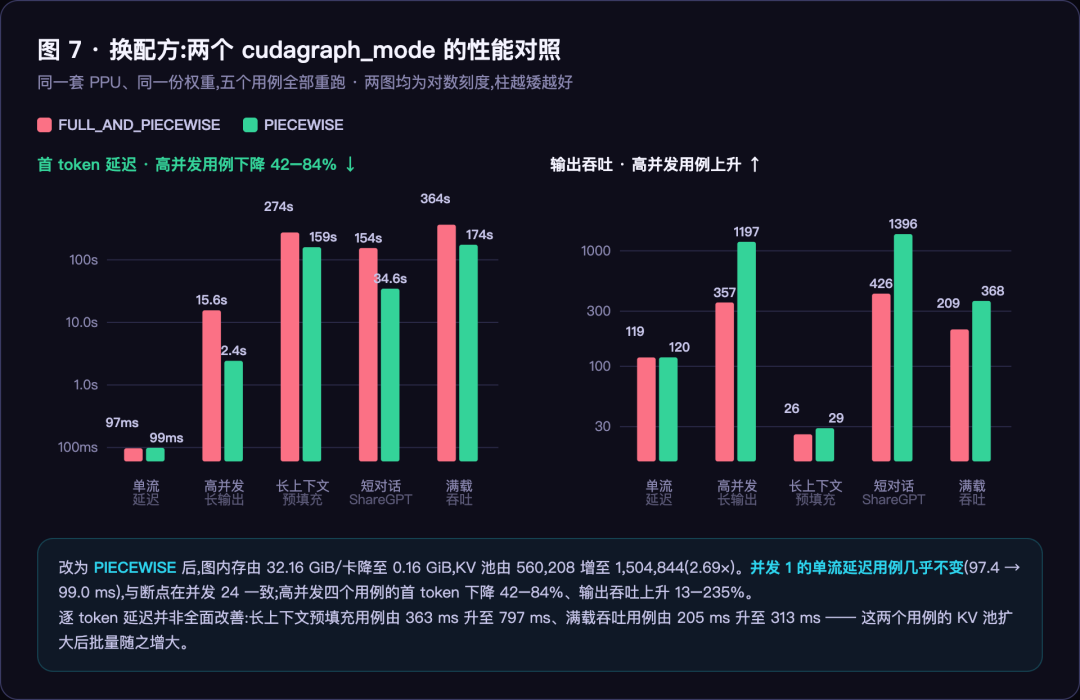
而 24 正是该引擎 CUDA graph 捕获档位表 [1, 2, 4, 8, 16, 24, 32, …] 里 16 之后的下一档。把 cudagraph_mode 从 FULL_AND_PIECEWISE 改成 PIECEWISE,其余不变,断崖消失:全并发段稳定在 53~56%。
结论:vLLM 0.26.0 的 full CUDA graph decode 路径,MTP 下批大小 ≥24 时接受率塌到 1% 左右。上游 vllm-project/vllm#48494 报的是同一路径的 capture 崩溃,规避方案同为回退 PIECEWISE——症状不同,规避一致。
换图模式对性能的影响不止接受率:
- 图内存从 32.16 GiB/卡 降到 0.16 GiB
- KV 池从 560,208 增到 1,504,844(2.69 倍)
- 并发 1 单流延迟几乎不变(97.4 → 99.0 ms),与断点在并发 24 一致
- 高并发四用例首 token 降 42~84%,输出吞吐升 13~235%
- 逐 token 并非全面改善:长上下文预填充从 363ms 升到 797ms、满载吞吐从 205ms 升到 313ms(KV 池扩大后批量随之增大)
横比一中 PPU 的全部数据取自换配方后重跑的那一轮。三条横比线里,本条决定了横比一的输入配置。
六、910B3 首 token 差距的成因
逐 token 受访存带宽约束:910B3 的 HBM 带宽是 A100 的 1/1.70,按规格应慢 1.70 倍,实测 2.04 倍,超出 20%,合理。
首 token 是算力密集:910B3 纸面 BF16 算力 313 TFLOPS,A100 是 312 TFLOPS,基本持平,按规格不该差 5.43 倍。纸面规格解释不了这个缺口。
该缺口与图捕获配置一致:
- A100(vLLM 0.25.1):有 prefill 图捕获,TTFT 94.6 ms
- PPU(vLLM 0.26.0):有 prefill 图捕获,TTFT 99.0 ms
- 910B3(vllm-ascend 0.23.0rc1):无 prefill 图捕获,TTFT 514.0 ms
把 TTFT 按”固定项 + 每 token 边际项”拟合(在 128~32,768 token 区间扫描):A100 为 130 ms + 13.05 μs/token,910B3 为 384 ms + 16.76 μs/token。边际项只差 1.28 倍,差距集中在固定项。
这 384 ms 的来源已实测确认:vllm-ascend 在平台初始化阶段关闭了可打断图且没有配置开关,prefill 的 64 层逐个 eager 下发,单次前向 3,357 个 kernel,实测下发速率约 100 μs/kernel。该开销按每次前向计而非每请求计,因此可被摊薄:prompt 从 128 增到 32,768,差距从 5.36 倍收敛到 1.95 倍;并发从 1 增到 16,收敛到 2.23 倍。单流延迟用例的 5.43 倍是固定开销占比最高的工作点,不代表常规负载下的表现。
七、测量边界
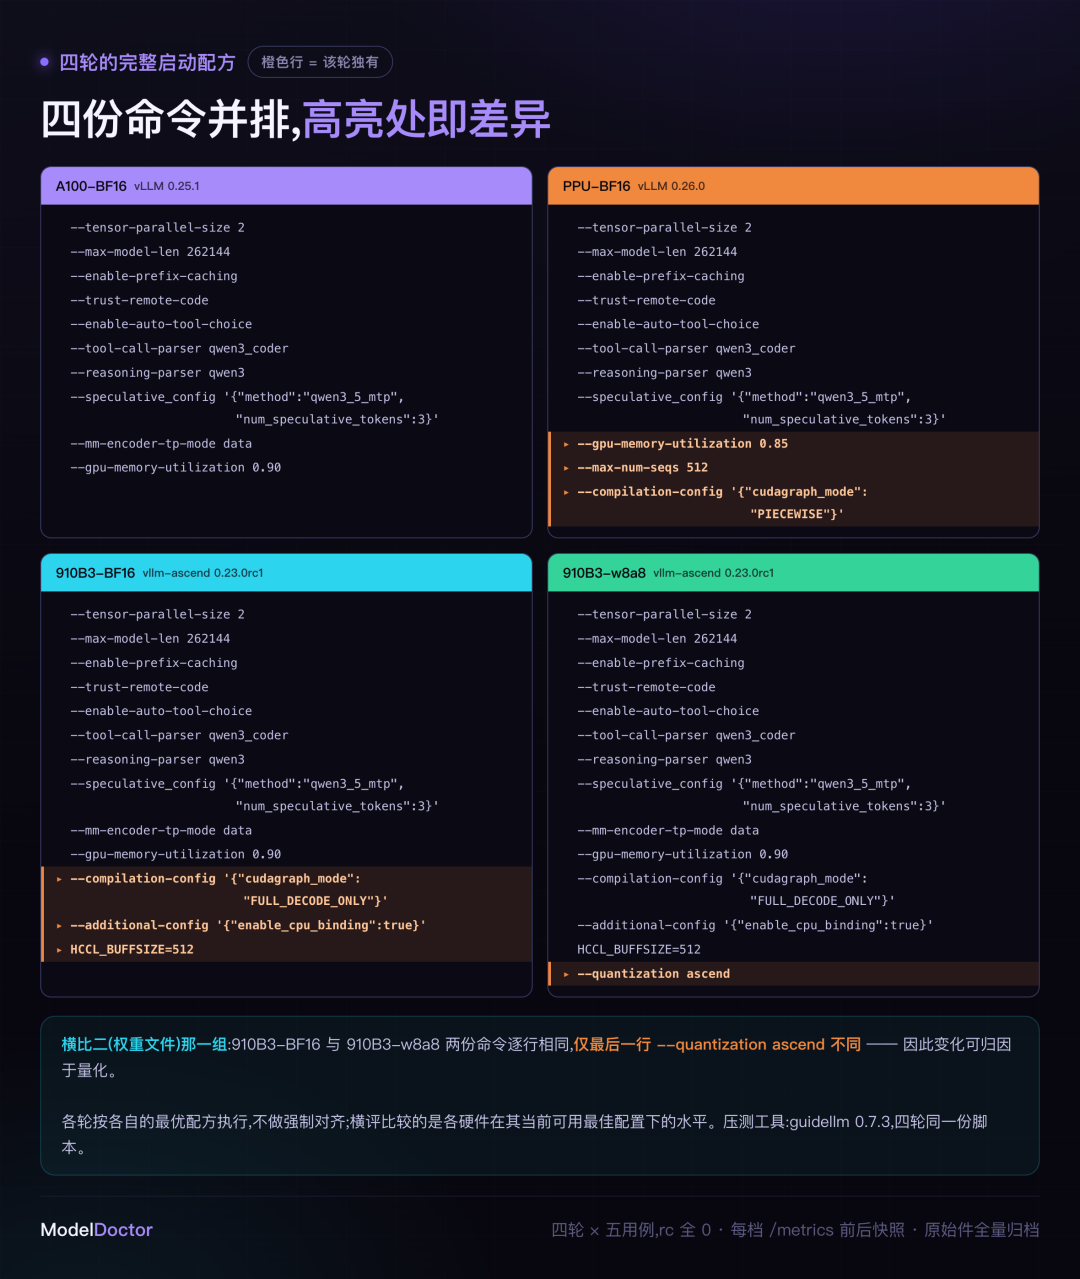
- 各轮用各自最优配方,不做强制对齐。四轮引擎版本与图模式确实不同(vLLM 0.25.1 / 0.26.0 / vllm-ascend 0.23.0rc1;FULL_AND_PIECEWISE / PIECEWISE / FULL_DECODE_ONLY),这是有意的:横评比的是”各硬件在其当前可用最佳配置下能到什么水平”,不是”同一份参数在不同硬件上的表现”。某一轮配方没调到最优,这个差距也该算进方案评价——横比三就是实例
- 五个用例中只有单流延迟用例 token 规格明确,其余四个由公开数据反推,短对话为合成分布。跨来源比值不可靠,本文比较只在这四轮之间进行
- 接受率只在固定温度下可比。guidellm 不发送 temperature,测的是模型默认采样值;sglang.bench_serving 默认发 temperature=0,同一部署实测差一档(73.62% vs 43.97%)
- 前缀缓存四轮都开,但合成随机 prompt 间无共享前缀,实测命中率均为 0%。吞吐数据不含缓存虚高,也未覆盖真实 agent 场景的高命中情况
复现所需的四轮完整启动命令见文末配图,橙色行即各轮独有参数。
关于作者与参考
聚焦 LLM 推理生产工程:vLLM / SGLang / MindIE 在国产卡、多集群网关、P/D 分离下的落地,推理编排与 SRE 实践沉淀在 recipes.mcpinfra.net 与压测工具 ModelDoctor。
文中数字均来自单次真实压测,不是普适”标准答案”——换数据集/参数,结论可能就变。欢迎拿自己的流量复现、指正。
- 参考1(公开对账数据):https://mp.weixin.qq.com/s/uLnPevDpk_70FSFMKaWcSQ
- 参考2(压测工具):https://github.com/vllm-project/guidellm
-
作者帖子
- 哎呀,回复话题必需登录。