-
作者帖子
-
2026年9月9日 上午12:10 #78
 teaikeji管理员
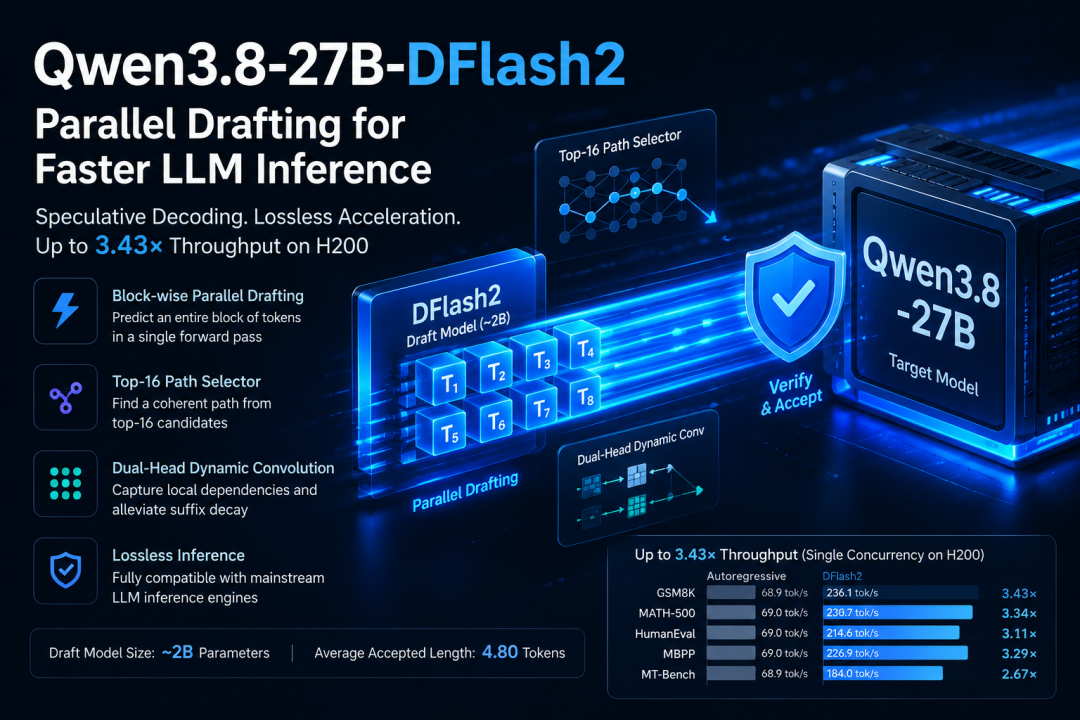
最近看到一个挺有意思的模型——Inco AI 基于 DFlash 技术推出的 Qwen3.8-27B-DFlash2。先说清楚:它不是一个能独立聊天的模型,而是专门配合 Qwen3.8-27B 使用的投机解码草稿模型(draft model)。核心思路一句话:把投机解码里”草稿阶段”也变成并行计算,在输出不损失质量的前提下压低解码成本。
一、先搞清楚它解决什么问题
传统投机解码大家都懂:小模型先”猜”几个 token,大模型一次性验证。但传统草稿模型自己还是逐 token 串行生成的,大模型的计算虽然省了,草稿阶段却还是有串行瓶颈。
DFlash 的改法很直接:草稿模型不再逐 token 生成,而是一次前向传播并行预测一整块 token。
DFlash2 又补了并行预测带来的两个坑:
- 每个位置独立预测,token 之间可能不连贯
- 位置越靠后,草稿准确率衰减越明显
所以它在 DFlash 基础上加了轻量路径选择器和双抽头动态深度卷积。官方模型卡写得很明确:它是 Qwen3.8-27B 的专用 draft model,不能脱离目标模型单独用。
二、一次并行猜一整块
流程可以简化成:用户输入 → Qwen3.8-27B 处理 → DFlash2 一次并行预测多个位置 → 每个位置保留 Top-16 候选 → 路径选择器找出连贯路径 → 目标模型一次性验证 → 对的接受、错的丢弃。
官方测试用 block size = 8,也就是每个验证周期产生 7 个 draft tokens 再交给目标模型验证。
这和传统投机解码最大的区别就一句:不是”小模型更快地逐个猜”,而是”小模型一次性并行猜一整块”。
三、亮点一:Top-16 路径选择器
并行预测最大的毛病是:每个位置都能出结果,但拼起来未必是一条自然的 token 序列。
DFlash2 没有去重跑大型 LM Head 做串行修正,而是每个位置保留 Top-16 候选,对相邻候选并行评分,找整体最连贯的路径。
官方数据(五层 Qwen3-4B DFlash 实验):
- 第一位置 Top-1 Recall:85.4%
- 第一位置 Top-16 Recall:99.5%
- 最后一个位置 Top-16 Recall 还有 87.8%
也就是说,正确 token 很多时候本来就在 Top-16 里,只是原来的 DFlash 没把它挑出来。这个选择器只加约 2M 参数、周期延迟约 0.6%,接受长度却明显提升;对比 DSpark 的修正机制,官方说参数开销少约 40 倍、延迟开销低约 16 倍。
四、亮点二:双抽头动态卷积治”后缀衰减”
预测块越靠后准确率越掉,官方管这个叫 Suffix Decay。原因是 DFlash 的注意力要同时干两件事:读上下文 + 建模草稿块内部的 token 关系。网络越深,分给块内依赖建模的注意力比例越低,后面的位置就越抓不住上下文。
DFlash2 的解法不是堆 Transformer 层,而是加双抽头动态深度卷积:每个位置混合当前 x_t 和前一个 x_(t-1) 的信息,第一个 draft position 则读已验证的最后一个 token 表示。这样在不放弃并行的前提下引入了相邻 token 的局部依赖。
这个卷积模块只加约 16.5M 参数(约 3%)、周期延迟约 0.7%,效果却接近加很多层 Transformer。设计思想其实很清晰:全局关系交给 Attention,短距离 token 关系交给轻量卷积。
五、为什么说它是”无损”的
DFlash2 不直接决定最终输出,最终结果仍由 Qwen3.8-27B 验证:草稿猜错就丢弃对应 token,猜对就一次接受多个。
官方模型卡明确:
- Greedy decoding 下输出与目标模型一致
- Sampling 模式下通过 rejection sampling 保持目标模型原有分布
所以它的价值不是”小模型替代大模型”,而是让大模型用更少的验证轮次生成同样的结果。
六、实测:单并发最高 3.43 倍
Inco AI 的测试环境是 NVIDIA H200 + SGLang + FlashAttention 3,Qwen3.8-27B 用官方推荐采样参数,block size 8。
平均接受长度上,DFlash2 在 GSM8K、MATH-500、HumanEval、MBPP、MT-Bench 五项全部领先,平均达到 4.80 token(对照 MTP 在 GSM8K 上 5.02、HumanEval 3.91 等)。
单并发吞吐方面,Qwen3.8-27B 自回归基线约 68.9~69.0 tok/s,官方公布的 DFlash2 实测加速范围是 2.67~3.43 倍——注意是范围,不是固定的”3.4 倍”。
高并发场景要泼盆冷水:并发 32 时优势明显缩小,五项任务加速只有约 1.01~1.45 倍。所以它最适合低并发、低延迟的推理场景,别理解成”任何负载下都能 3 倍”。
七、它只是个 2B 的”配件”
Hugging Face 模型卡显示 DFlash2 权重约 2B 参数、BF16。这里容易误解:下载一个 2B 模型 ≠ 拥有 Qwen3.8-27B。正确理解是:Qwen3.8-27B 负责最终生成(target model),DFlash2 负责提候选(draft model),两者必须一起用。
八、怎么部署
官方给了 SGLang、vLLM、llama.cpp、Ollama、oMLX 等方案。SGLang 示例:
python -m sglang.launch_server
  --model-path Qwen/Qwen3.8-27B
  --speculative-algorithm DFLASH
  --speculative-draft-model-path incoai/Qwen3.8-27B-DFlash2
  --speculative-num-draft-tokens 8
vLLM 用 DFlash2 支持版本,配置:
vllm serve Qwen/Qwen3.8-27B
  --speculative-config '{
    "method": "dflash",
    "model": "incoai/Qwen3.8-27B-DFlash2",
    "num_speculative_tokens": 7
  }'
llama.cpp 用对应 PR 分支,`–spec-type draft-dflash` 启用,目标模型和草稿模型分别加载 Qwen3.8-27B 和 DFlash2 的 GGUF。
资源都在下面,自己折腾可以对着来。
九、一句容易被忽略的话
DFlash2 不会让 Qwen3.8-27B 变得更聪明——知识、推理、代码能力一分没涨。它优化的是”同一个目标模型 → 更少的验证轮次 → 更高的输出速度”,属于推理基础设施优化,不是新基础模型。
顺便提一句,Qwen3.8-27B 本身是 27B 多模态模型(视觉输入、视频理解、思考模式、原生 MTP),DFlash2 是站在模型外面给它加的一条加速路径。
官方资源:
- 技术博客:https://inco.ai/blog/dflash2/
- GitHub:https://github.com/z-lab/dflash
- 草稿模型:https://huggingface.co/incoai/Qwen3.8-27B-DFlash2
- 目标模型:https://huggingface.co/Qwen/Qwen3.8-27B
你们跑 Qwen3.8 时用的什么加速方案?MTP 原生够用还是想折腾投机解码,楼下聊聊。
-
作者帖子
- 哎呀,回复话题必需登录。