-
作者帖子
-
2026年9月9日 上午12:09 #76
 teaikeji管理员
最近把 Qwen3.8-27B 拉到本地,接进编程 agent 想让它干点实际的活,一开始的效果相当拉垮:不听指令、不调工具,基本就只会陪聊。
但看榜单它明明不差:SWE-bench Pro 上拿了 61.7 分,比 opus 4.6-max 的 53.4 还高,纯对话场景实测体验也确实可以。所以问题不在模型本身,而在打开方式。折腾了一轮之后,发现关键是把下面两件事换掉。
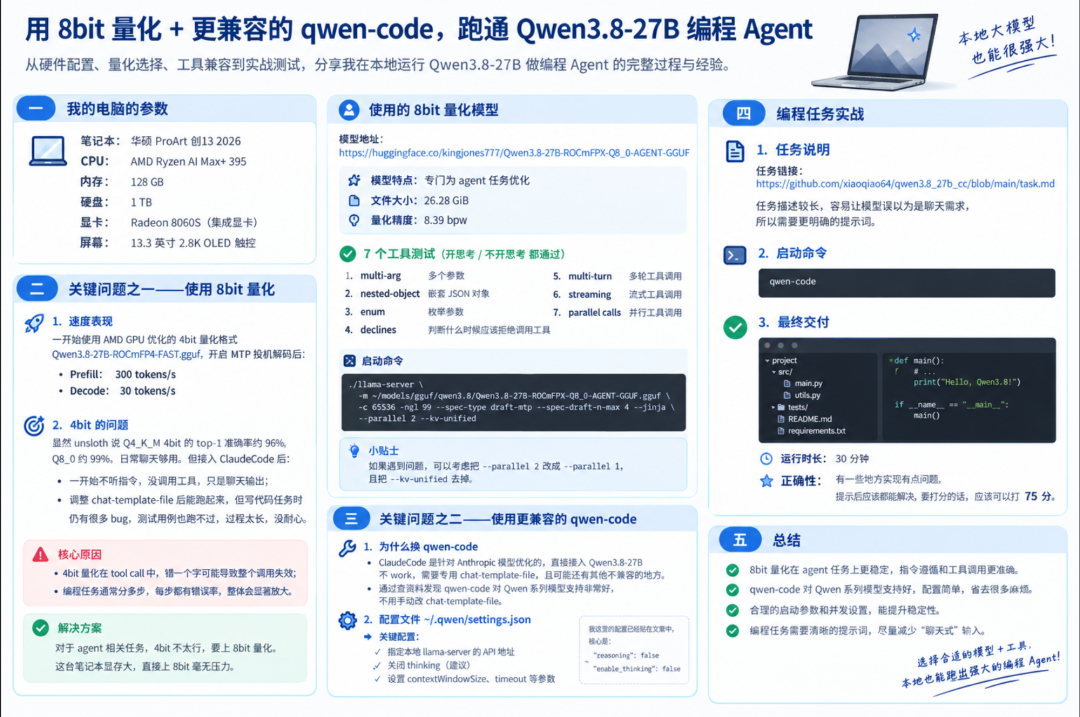
一、机器参数
这台笔记本显存比较大,后面量化档位怎么选基本靠它兜底。
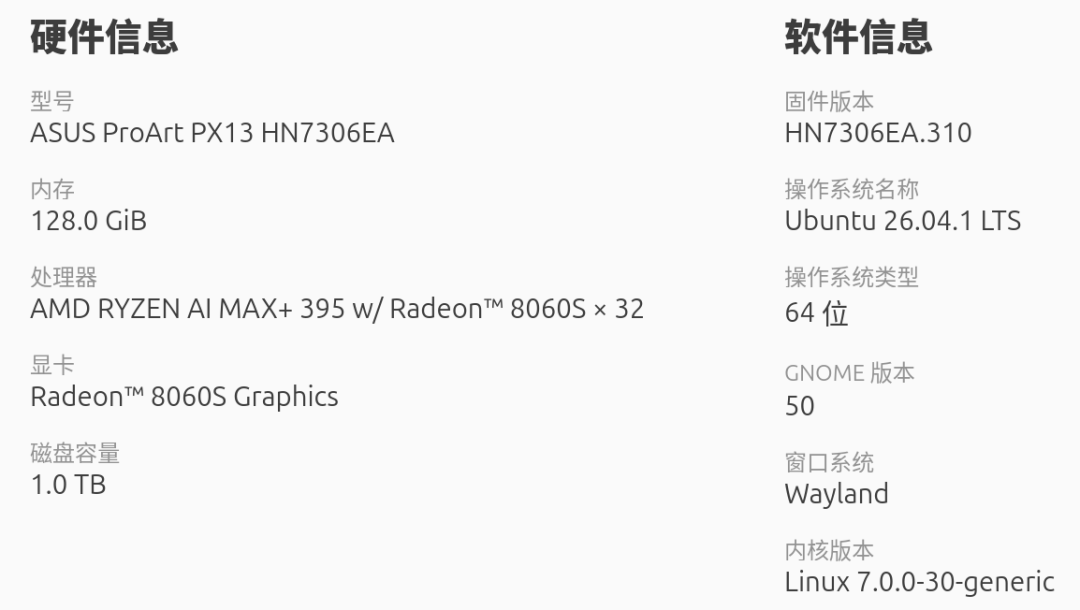
二、把 4bit 量化换成 8bit
一开始用的是为 AMD 显卡优化的 4bit 版本 Qwen3.8-27B-ROCmFP4-FAST.gguf,开 mtp 投机解码后 prefill 能到 300 tokens/s,decode 30 tokens/s,速度确实快。
按 unsloth 的说法,Q4_K_M 这种 4bit 量化的 top-1 准确率(预测的下一个 token 与原模型完全一致的比例)相对原模型大概 96%,Q8_0 大概 99%。日常聊天用 4bit 基本无感,但一接到 agent 上就露馅了,原因有两个:
- tool call 是结构化输出,参数里错一个字,整个工具调用就废了
- 编程任务基本都是多步的,每一步多一点点错误率,累积下来会显著放大
4bit 的指令遵循撑不起这个要求。我这边显存够大,直接上 8bit 没压力。模型用的是这个专为 agent 任务优化过的版本,26.28 GiB、8.39 bpw:
https://huggingface.co/kingjones777/Qwen3.8-27B-ROCmFPX-Q8_0-AGENT-GGUF
作者测了 7 项工具能力,开不开思考模式全部通过:
- multi-arg:多参数
- nested-object:嵌套 JSON 对象
- enum:枚举参数
- declines:判断何时应该拒绝调用工具
- multi-turn:多轮工具调用
- streaming:流式工具调用
- parallel calls:并行工具调用
llama.cpp 启动命令:
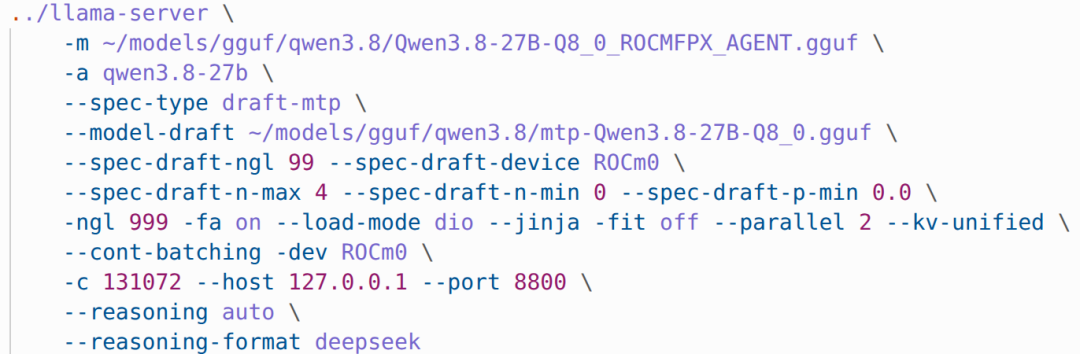
如果启动后遇到问题,可以把 –parallel 2 改成 –parallel 1,再把 –kv-unified 去掉试试。
三、把 Claude Code 换成 qwen-code
agent 侧也有讲究。我一开始用的是 Claude Code(CC),编程 agent 里它确实做得不错,但它整体是针对 Anthropic 家模型优化的。llama.cpp 虽然支持 Anthropic 的 API 格式,直接把 Qwen 接进 CC 还是不 work——得传专用 chat-template-file 才能跑起来。看得见的地方要手动补,看不见的兼容性问题还会继续拖效果。
后来查到 qwen-code,对 Qwen 系模型支持非常好,也不用手动改 chat-template-file,既能接云端模型,也能接本地 llama.cpp 的 API。我的 ~/.qwen/settings.json 配置如下:
{
  "modelProviders": {
    "openai": [
      {
        "id": "qwen3.8-27b",
        "name": "qwen3.8-27b (local llama-server)",
        "baseUrl": "http://127.0.0.1:8800/v1",
        "description": "Local Qwen3.8-27B Q8 via llama-server",
        "envKey": "OPENAI_API_KEY",
        "generationConfig": {
          "timeout": 600000,
          "streamIdleTimeoutMs": 600000,
          "maxRetries": 1,
          "contextWindowSize": 131072,
          "reasoning": false,
          "extra_body": {
            "chat_template_kwargs": {
              "enable_thinking": false
            }
          }
        }
      }
    ]
  },
  "env": {
    "OPENAI_API_KEY": "local"
  },
  "security": {
    "auth": {
      "selectedType": "openai"
    }
  },
  "model": {
    "name": "qwen3.8-27b",
    "reasoningEffort": "none"
  },
  "$version": 4,
  "permissions": {
    "autoMode": {
      "classifier": {
        "timeouts": {
          "stage1Ms": 60000,
          "stage2Ms": 120000
        }
      }
    }
  }
}
给 agent 用建议把 thinking 关掉,开着也能用,就是慢。我是在 qwen-code 的配置里关的,llama.cpp 启动命令本身没动。
四、一个真实编程任务实测
任务还是之前那个:https://github.com/xiaoqiao64/qwen3.8_27b_cc/blob/main/task.md
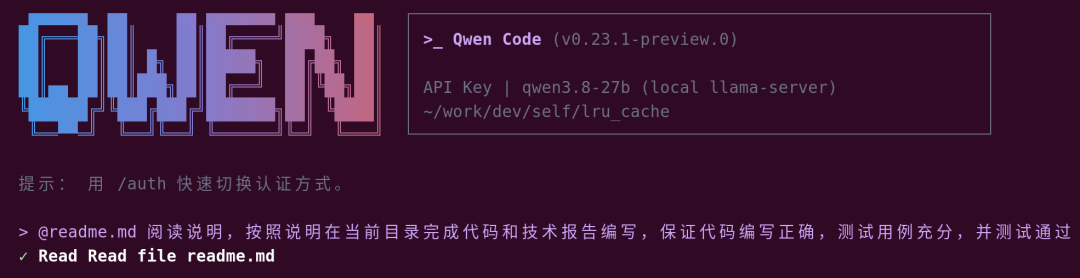
这个任务描述性文字偏多,容易让模型误以为是聊天需求,弱模型多半就栽在这上面。
输入的命令:
最终交付:
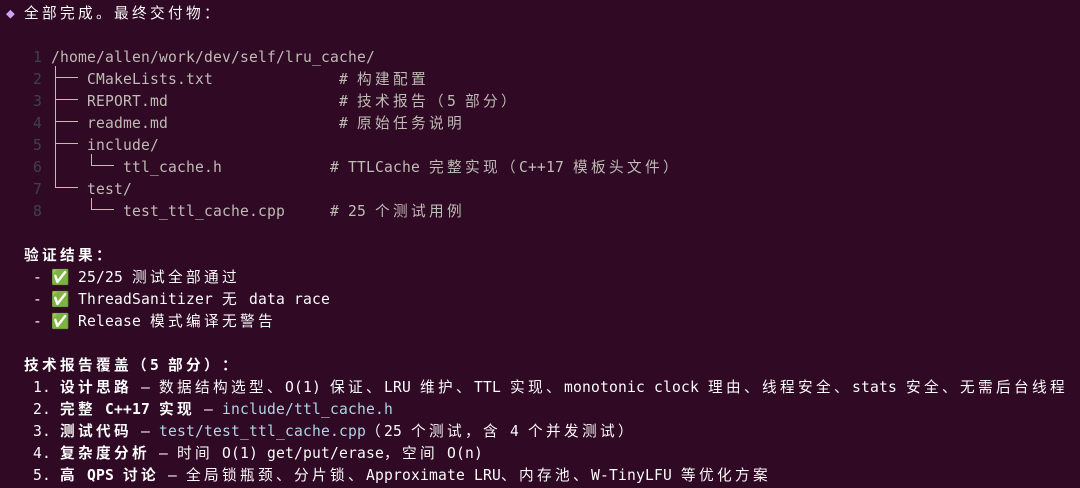
整轮跑完 30 分钟。正确性上个别地方实现有点问题,提示之后都能解决,要打分的话 75 分左右。
结论
本地部署的模型要接 agent 干活,两条经验:
1. 尽量用原版或高比特量化。4bit 撑不住 agent 的指令遵循要求,实测 Q8 可用。
2. Qwen 系模型配 qwen-code 用,比硬接 Claude Code 兼容性好得多。
你们本地跑 Qwen 接 agent 是什么体验?4bit 和 8bit 的差距体感有多大,楼下聊聊。
-
作者帖子
- 哎呀,回复话题必需登录。